

旁白故事
守塔人的最后一夜
4:36 · 16:9 · 5 章 · 旁白 · 字幕
提示词
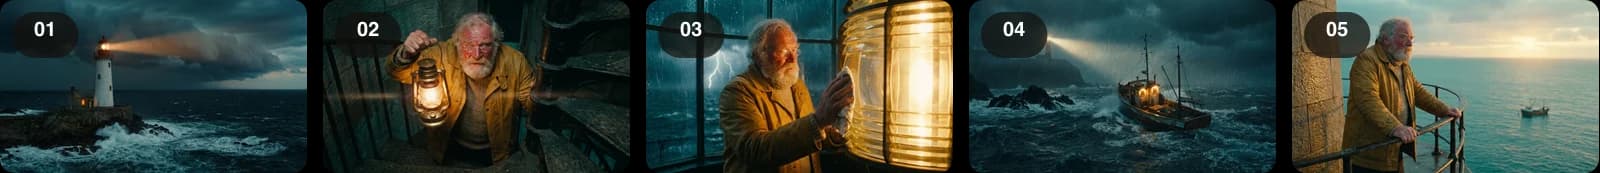
一个 4 分钟的旁白故事:灯塔改为自动化之前,一位年迈守塔人的最后一夜。暴风雨,遇险的渔船,宁静的日出。电影感,16:9,开启字幕。

给 ClipNova 一张照片或一段文字。它会搭建分镜、生成每一个场景、录制旁白、同步字幕、混入你自己的音乐,并交付可直接上传的成片。
旁白故事、儿童动画剧集和不露脸纪录片,是 ClipNova 上最常制作的长视频。下面是我们自己做的三个示例,每个都只用了一条简短的提示词。
一个 4 分钟的旁白故事:灯塔改为自动化之前,一位年迈守塔人的最后一夜。暴风雨,遇险的渔船,宁静的日出。电影感,16:9,开启字幕。
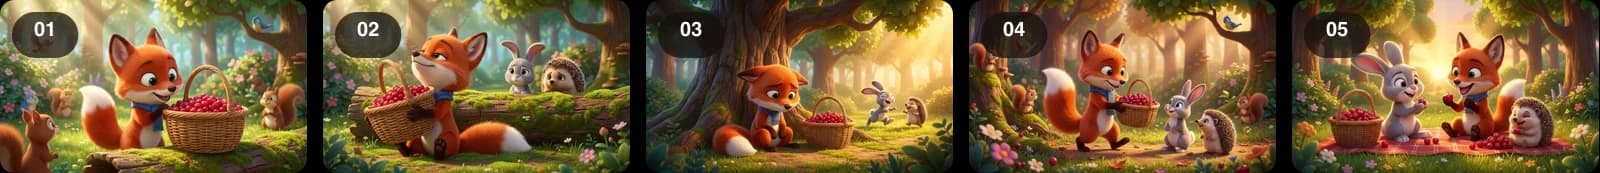
一部 3 分钟的儿童动画,采用明亮的 3D 动画电影风格:小狐狸米洛发现一篮浆果,不肯和朋友分享,感到孤单,最后学会了分享。温柔的讲述人,16:9。
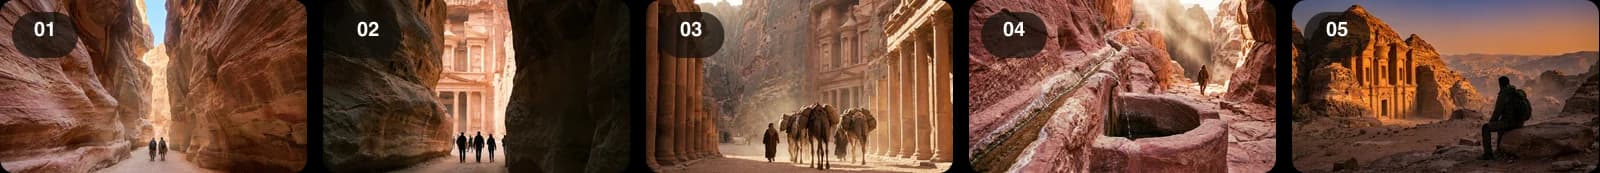
一部关于失落之城佩特拉的 4 分钟不露脸纪录片:西克峡谷、卡兹尼神殿、纳巴泰商人和他们的水渠、代尔修道院。沉稳的讲述人,16:9,字幕。
下面的每一步都在一次生成中完成。这里用的是同一个项目,《守塔人的最后一夜》,一个 4 分钟的旁白故事,从创意一直到最终导出。
上传一张照片,或写下视频的主题、时长和目标观众。一段话就够了。ClipNova 会理解你的意图,在渲染任何画面之前先定下基调、节奏和目标时长。
创意变成逐场景的规划:每个场景展示什么、持续多久、镜头如何运动、旁白说些什么。长视频像电影一样按章节和节拍来规划,而不是一条没完没了的提示词。
分镜中的每个节点都有自己的起始图像,并被制作成约 6 秒的动态镜头,从第一个镜头到最后一个镜头保持同样的风格、光线和调色。每一章都有自己的画面,所以 5 分钟的成片绝不会像循环播放。
分镜中的文案由自然的 AI 旁白朗读,支持 18 种语言,逐场景对齐时间。选择一个声音,或克隆你自己的声音;同一支视频可以为另一个市场重新配音,无需重新渲染画面。
上传音乐文件或粘贴音乐链接,设置它在旁白下方的音量,并选择播放曲目的哪一段,结尾还可选择淡出。ClipNova 会把它混入最终成片。无需时间线,无需手动剪裁。
字幕从配音中转写并烧录进视频,随着旁白的朗读逐字高亮。字幕样式只需选择一次,全片保持一致,即使静音观看也能看懂。
场景、配音、音乐和字幕会合成为一个带章节的文件。可导出适合 YouTube 的 16:9,或适合 Shorts、Reels 和 TikTok 的 9:16,最高 1080p,无水印并享有完整商业使用权。修改简介中的一行,几分钟即可重新渲染。
文生视频模型只能给你五到十五秒的素材。那是一个镜头,不是一支视频。长视频 AI 生成器必须解决镜头之外的一切:能让观众持续几分钟保持注意力的结构、彼此风格一致的场景、推动故事的旁白、随之起伏的音乐,以及让视频在静音时依然能看下去的字幕。
ClipNova 把这一切当作一件事来做。先写分镜,所以每个场景都有存在的理由和在时长中的位置。场景按照这份规划以统一的风格渲染。人声和字幕由同一份文案生成,你的音乐则混在它们下方,因此无需剪辑师也能严丝合缝。你得到的是一支完整的成片,而不是一个装满片段的文件夹。
因为规划本身是文字,修改视频就是修改文字。缩短一个章节、更换旁白语言、把行动号召提前,然后重新渲染。每次渲染最长可生成 5 分钟的视频,更长的项目可以用一致的角色和场景串联起来。
把一个主题变成最长 5 分钟、带旁白和字幕的分章节视频,一帧都不用拍。
用文字需求按计划发布长视频。同一个声音、同一种风格,每次都是新脚本。
把一个产品、一套流程或一节课程讲清楚,整支视频每个章节都保持一致。
从一张产品图或创始人照片出发,让场景和人声围绕它把故事讲完整,再配上你自己的音乐。
一种根据需求生成完整的数分钟视频、而非单个短片段的工具。在 ClipNova 中,这意味着分镜、场景、配音和字幕全部由你的图片或文字生成,如果你添加了自己的音乐也会一并混入,最终合成为一个完整的成片文件。
单次渲染最长 5 分钟。长视频由约 6 秒的镜头组成,每个镜头都从自己的起始图像生成动画,因此 60 秒的成片大约有十个镜头,5 分钟的视频则按章节组织。更长的项目可以用相同的角色和场景把多次渲染串联起来。
不需要。ClipNova 会根据你的需求撰写分镜和旁白。如果你已经有脚本,直接粘贴,工具会逐场景照着执行。
旁白支持 18 种语言,字幕由人声转写而来,因此两者会一起切换。你可以为另一个市场重新配音一支已完成的视频,无需重新生成场景。
可以。重新剪辑场景、替换镜头、更换旁白、调整音乐或修正字幕,然后在几分钟内重新渲染新版本。因为规划是文字,大多数修改只是改一改需求。
适合 YouTube 的 16:9,或适合 Shorts、Reels 和 TikTok 的 9:16,最高 1080p,无水印。渲染前选好画幅,每个场景都会按该画幅生成。


